
生成AI塗りつぶしを理解する
生成塗りつぶしの背後にある技術を学び、AIが既存の写真とシームレスに溶け込む新しい画像コンテンツをどのように作り出すかを理解しましょう。
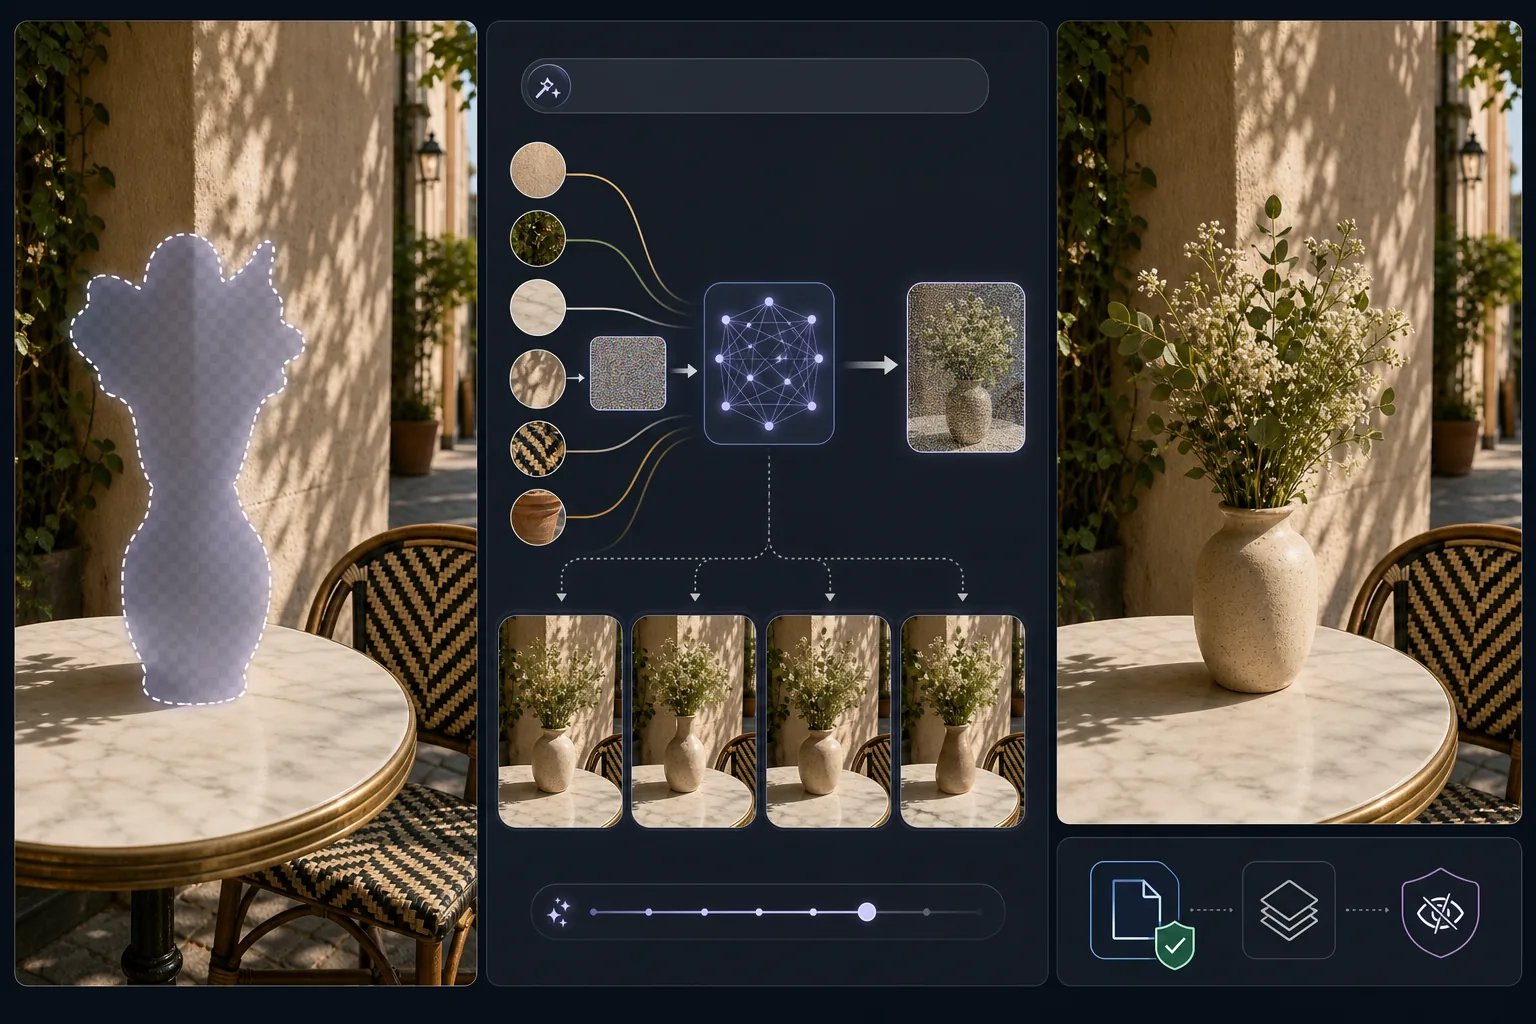
Lesson context before the long read
Review the result preview above, then scan the learning objectives below before reading the full lesson. Updated 2026-05-17.
Example visual uses an existing public asset: /content-images/generative-fill-understanding-academy.webp.
Learning Objectives
- 1拡散ベースのインペインティングモデルが選択した領域内で新しいコンテンツをどのように生成するかを理解する
- 2選択範囲のサイズ、コンテキスト、プロンプトの具体性など、生成塗りつぶしの品質に影響する要因を特定する
- 3写真におけるAI生成コンテンツの倫理的配慮と限界を認識する
生成塗りつぶしが異なる点
生成塗りつぶしは、拡散ベースのAIモデルを使用して、選択した領域内にまったく新しい画像コンテンツを作成します。近接領域から既存のピクセルを複製してブレンドする従来のコンテンツに応じた塗りつぶしとは異なり、生成塗りつぶしは画像のどこにも存在しないオブジェクト、テクスチャ、シーンを生み出すことができます。モデルは色、光の方向、遠近線、被写体などの周囲のコンテキストを分析し、元の写真の自然な一部のように見えるコンテンツを生成します。
AIがどのように文脈に応じたコンテンツを生成するか
生成塗りつぶしの結果の品質はいくつかの重要な要因に依存します。画像全体に対する選択領域のサイズが重要です。周囲のコンテキストが豊富な小さな選択範囲は、モデルが一致させるための明確な視覚情報を持つため、最も説得力のある結果を生み出します。プロンプトの具体性も要因の一つで、生成したい内容のテキスト記述を提供することで、モデルが推測に頼るのではなく、意図した結果へと導かれます。光の一貫性、遠近の正確さ、テクスチャの一致はすべてモデルが内部で評価しますが、強い方向性のある光や異常な遠近を持つ複雑なシーンでは、複数回の生成試行が必要になる場合があります。
生成塗りつぶしに最適なシナリオ
生成塗りつぶしは強力なクリエイティブツールですが、写真内にコンテンツを生成することの倫理的な意味を考慮することが重要です。元々存在しなかったオブジェクトや人物を写真に追加することは、特にジャーナリズム、法的証拠、ドキュメンタリーの文脈において、画像の信頼性に関する疑問を提起します。多くの専門組織は、AI生成コンテンツが写真に追加された場合に開示を求めています。ベストプラクティスとして、編集していない元のファイルを別途保存し、信頼性が求められる文脈では生成的な編集について透明性を保ちましょう。
Key Takeaways
- ✓生成塗りつぶしは既存のピクセルから複製するだけでなく、拡散モデルを使用して新しいコンテンツを作成する
- ✓周囲のコンテキストが豊富で具体的なテキストプロンプトを伴う小さな選択範囲が最良の結果を生む
- ✓信頼性が重要な場合は元のファイルを保存し、AI生成による追加を開示する